Zenn
初めて事前学習モデルを作った!車両の輪郭を塗る「JALO」の開発記録
初めて、自分で事前学習モデルを作りました。名前は「JALO」です。
初めて、自分で事前学習モデルを作りました。名前は「JALO」です。
運転動画に映る車両を認識し、車体の輪郭に沿って半透明の色を重ねるモデルです。モデルの実装、学習、未学習動画での評価、重みの公開まで取り組みました。1
この記事は、高精度なモデルの完成報告ではありません。初めて作ったモデルがどこまで動き、何がまだ難しかったのかを、実際の出力と図で紹介する開発記録です。
https://github.com/james-yusuke/jalo
1. まずは、初めて作ったモデルの出力から
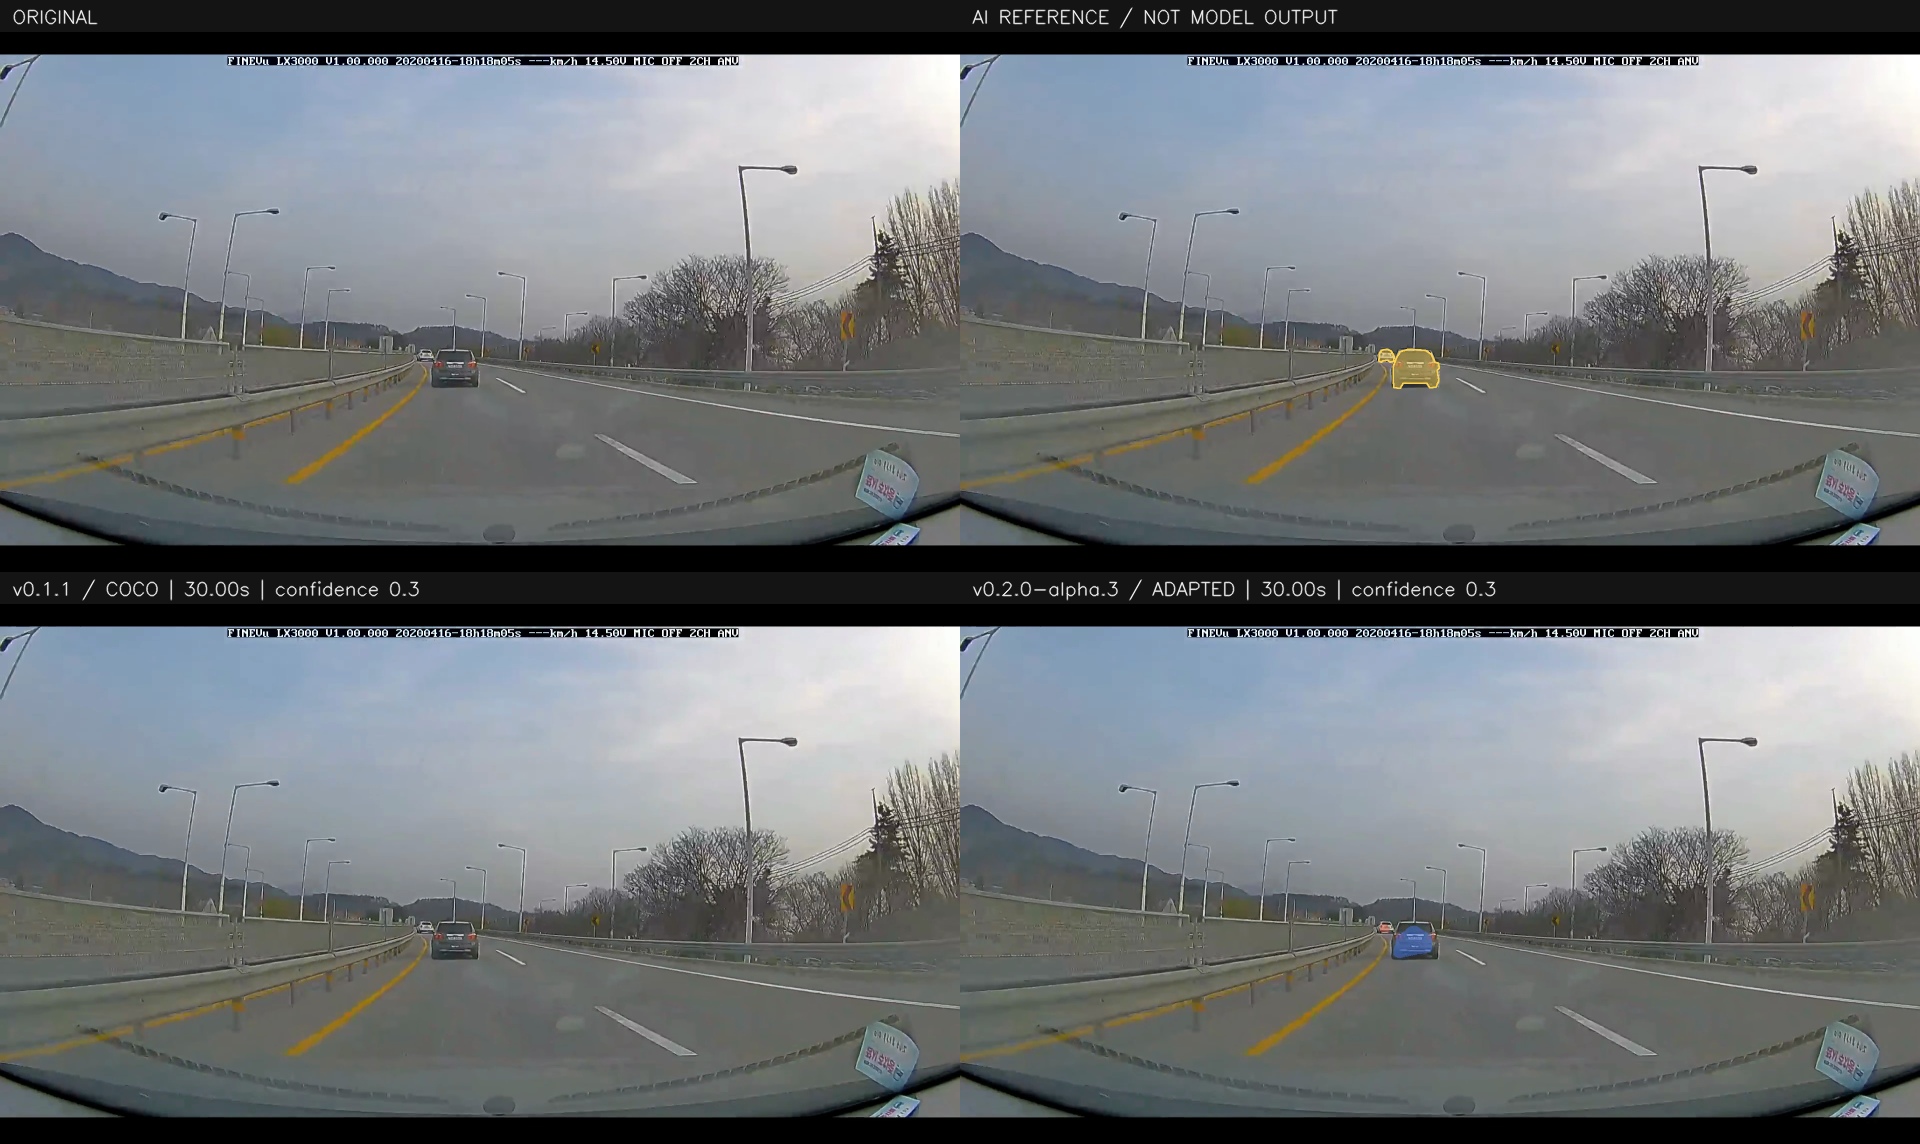 図1:左上=原映像、右上=AI参照注釈、左下=旧モデル、右下=現在の配布モデル。比較画像はJALOリポジトリより。2
近距離の車両では、車体に沿った着色ができるようになりました。ただし、塗り残しや路面へのはみ出しも残っています。「色が付いた」だけで成功とはしないことが、今回の評価の出発点です。2
現在の配布版は v0.1.0(研究版)。画像中の v0.1.1 は比較対象の旧番号で、現在は採番をやり直しています。1
2. 「初めて作った」のは、どの部分?
:::message ここでいう「事前学習モデル」は、推論や次の追加学習の出発点として使える、車両認識用の学習済み重みです。すべての重みをランダム初期化して学習したわけではありません。 特徴抽出にはImageNet学習済みのResNet-18を使っています。3 :::
flowchart TB
    A["外部の学習済み重み<br/>ImageNet / ResNet-18"]
    B["自分の車両認識モデル<br/>COCOで学習した旧試作"]
    C["構造を改良して追加学習<br/>運転動画 + COCO"]
    D["初めてのモデル公開<br/>JALO v0.1.0"]
    A -->|特徴抽出の土台| B
    B -->|学習済み部分を継承| C
    C -->|推論用の重みを配布| D
図2:外部の重みを使う部分と、自分で学習・改良した部分。3
既存の学習済み検出・セグメンテーションモデルを、そのまま動かしたものではありません。ResNet-18を土台に、車両の候補や輪郭を予測する構造を組み、学習しました。初挑戦で取り組んだのは、この一連のモデルづくりです。3
3. 車を「枠で囲む」のではなく、「輪郭で塗る」
対象は car・truck・bus の3クラスです。車両ごとの領域を予測する「インスタンスセグメンテーション」を使い、見えている車体を塗ります。検出枠は表示せず、追跡IDごとに色をそろえます。1
flowchart TB
    A["動画から取り出した1フレーム<br/>入力 544 × 960"]
    B["ResNet-18<br/>画像の特徴を取り出す"]
    C["中心ヒートマップ + 初期矩形<br/>100個の車両候補を作る"]
    D["Attentionで候補を更新<br/>192次元 / 6ヘッド / 3層"]
    E["予測した車両領域の特徴を切り出す<br/>28 × 28"]
    F["車両ごとの局所マスク<br/>56 × 56"]
    G["画像全体の<br/>車両前景を予測"]
    H["局所マスクと車両前景<br/>両方が成立する画素を残す"]
    I["ByteTrackで追跡IDを付与<br/>半透明の色を重ねる"]
    A --> B
    B --> C
    C --> D
    D --> E
    B -->|切り出し元の特徴| E
    E --> F
    B --> G
    F --> H
    G --> H
    H --> I
図3:推論の概略。矩形は内部の切り出しに使い、画面には描きません。3
「車両の候補を探す → 周囲の特徴を見る → その車両の輪郭を予測する」という流れです。参照注釈や正解の矩形を推論時に渡して、結果を補正する処理はありません。3
4. 学習用と評価用は、動画ごと分けた
運転動画4本から、合計 340枚 の参照画像を用意しました。学習用の動画は2本、検証と最終評価はそれぞれ別の1本です。4
flowchart TB
    A["運転動画4本から抽出<br/>合計340枚"]
    B["学習用:190枚<br/>I-495 / Broad Creek"]
    C["検証用:95枚<br/>Leaman Farm Road"]
    D["最終評価用:55枚<br/>原州市の運転動画"]
    E["COCO 2017 train<br/>追加学習用の2,000枚"]
    F["動画画像とCOCOを<br/>1対1で混ぜて学習"]
    G["モデルと<br/>しきい値を選ぶ"]
    H["選択が終わってから評価<br/>この結果では調整しない"]
    A --> B
    A --> C
    A --> D
    B --> F
    E --> F
    C --> G
    D --> H
図4:学習・検証・最終評価の役割。COCOの2,000枚は、追加学習で混ぜたデータです。4
参照注釈はAIが作成し、AIが確認したものです。独立した人手検証は受けていません。 この評価は、特定の動画と参照注釈に基づく実験結果として扱います。2
5. 少数の画像から、段階的に学習を進めた
注釈がそろうのに合わせて、学習用の動画画像を増やしました。最初は8枚で、少数の画像に十分適合できるかを確認しています。4
flowchart TB
    A["8枚<br/>まず少数画像で学習を確認"]
    B["20枚<br/>学習画像を追加"]
    C["36枚<br/>さらに対象を増やす"]
    D["126枚<br/>学習を継続"]
    E["190枚<br/>全学習用注釈を使用"]
    A --> B --> C --> D --> E
図5:追加学習に使う動画画像を増やした流れ。検証・最終評価画像は含みません。4
追加学習・評価は、破棄した試行も含めて 7時間4分・13,961更新。全注釈を使う段階では、検証により 4,000更新時点 のモデルを選びました。これは初期のCOCO学習や注釈作成、実装、動画書き出しまで含めた総開発時間ではありません。2
6. 改善した。でも、合格には届かなかった
最終評価で、着色画素Precisionは 94.1%。一方、長辺32px以上の車両Recallは 75.7% で、目標の80%に届きませんでした。以下は追跡を含む、実際の着色処理の値です。2
flowchart TB
    A["未学習動画での最終評価<br/>参照画像55枚"]
    B["着色画素Precision<br/>94.1%"]
    C["車両Recall<br/>75.7%:109 / 144件"]
    D["誤着色率<br/>背景 0.171% / 車内 0.017%"]
    E["基準:90%以上<br/>この項目は達成"]
    F["基準:80%以上<br/>この項目は未達"]
    G["基準:それぞれ0.5%以下<br/>この項目は達成"]
    A --> B --> E
    A --> C --> F
    A --> D --> G
図6:最終評価の主要指標。総合判定には、検証・最終評価それぞれで、追跡前と描画後の条件を満たす必要があります。2
「塗った場所は合っているか」と「塗るべき車を見逃していないか」は別の問題です。検証側の車両Recallも63.2%にとどまりました。きれいに塗れた場面だけでなく、見逃しを含めて未達と判断しています。2
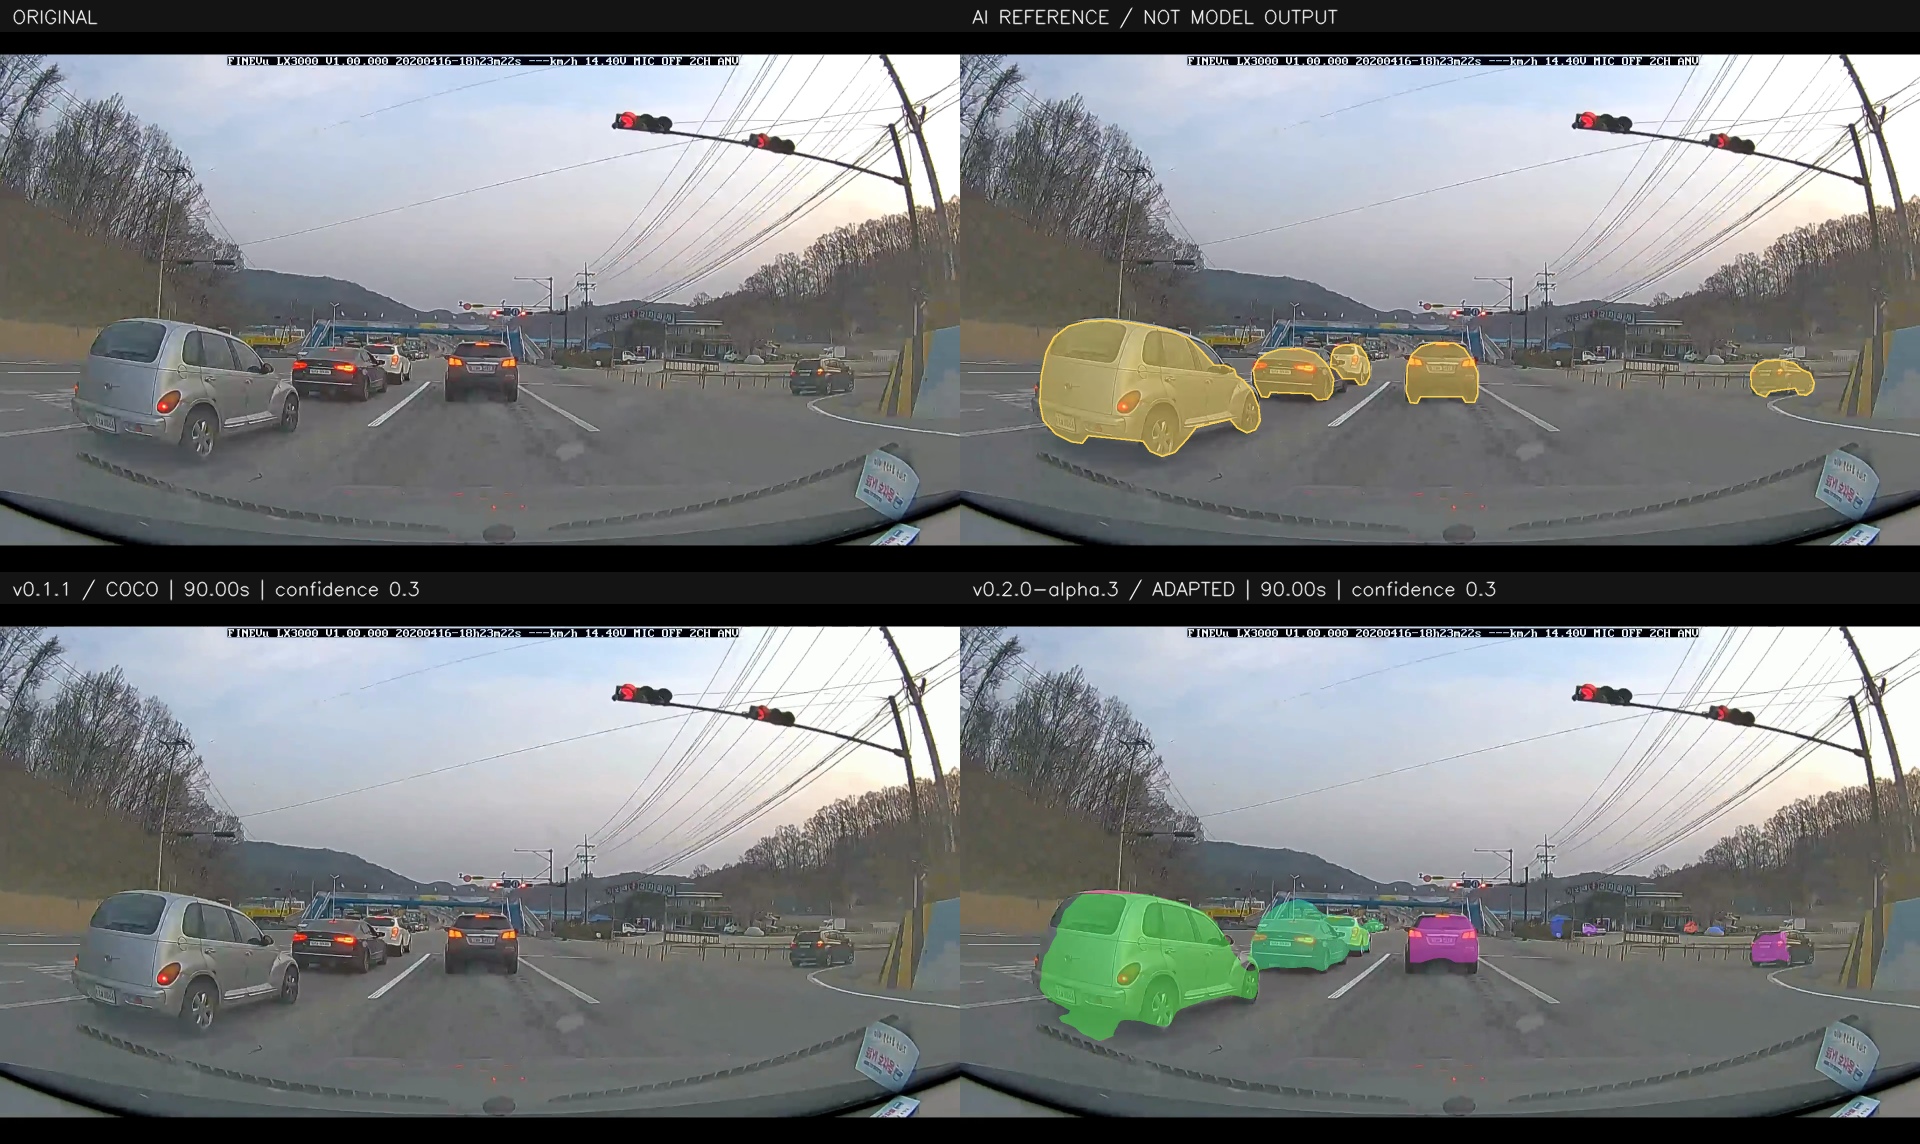 図7:90秒地点の比較。配置は図1と同じです。車体下端付近のはみ出しも、改善が必要な点です。2
:::details 評価条件をもう少し詳しく 車両Recallは、同じクラス同士でマスクIoUが0.5以上になるものを一対一で対応付けて計算しています。ignore領域を除いた最終評価対象は、長辺32px以上が144件、32px未満が19件です。同じ車両が別の時刻に登場する例も含むため、「144台の異なる車」という意味ではありません。
改善版のクラスしきい値は0.3、局所マスクと車両前景のしきい値はそれぞれ0.5、描画の透明度は45%です。何も塗らなければ背景への誤着色は減らせますが、そのような結果は合格にしません。
マスクAPなどの追跡前の指標と、着色後のPrecision・Recallは定義が異なります。詳細はREADMEの測定条件にまとめています。 :::
7. 初挑戦で残ったのは、こんな課題
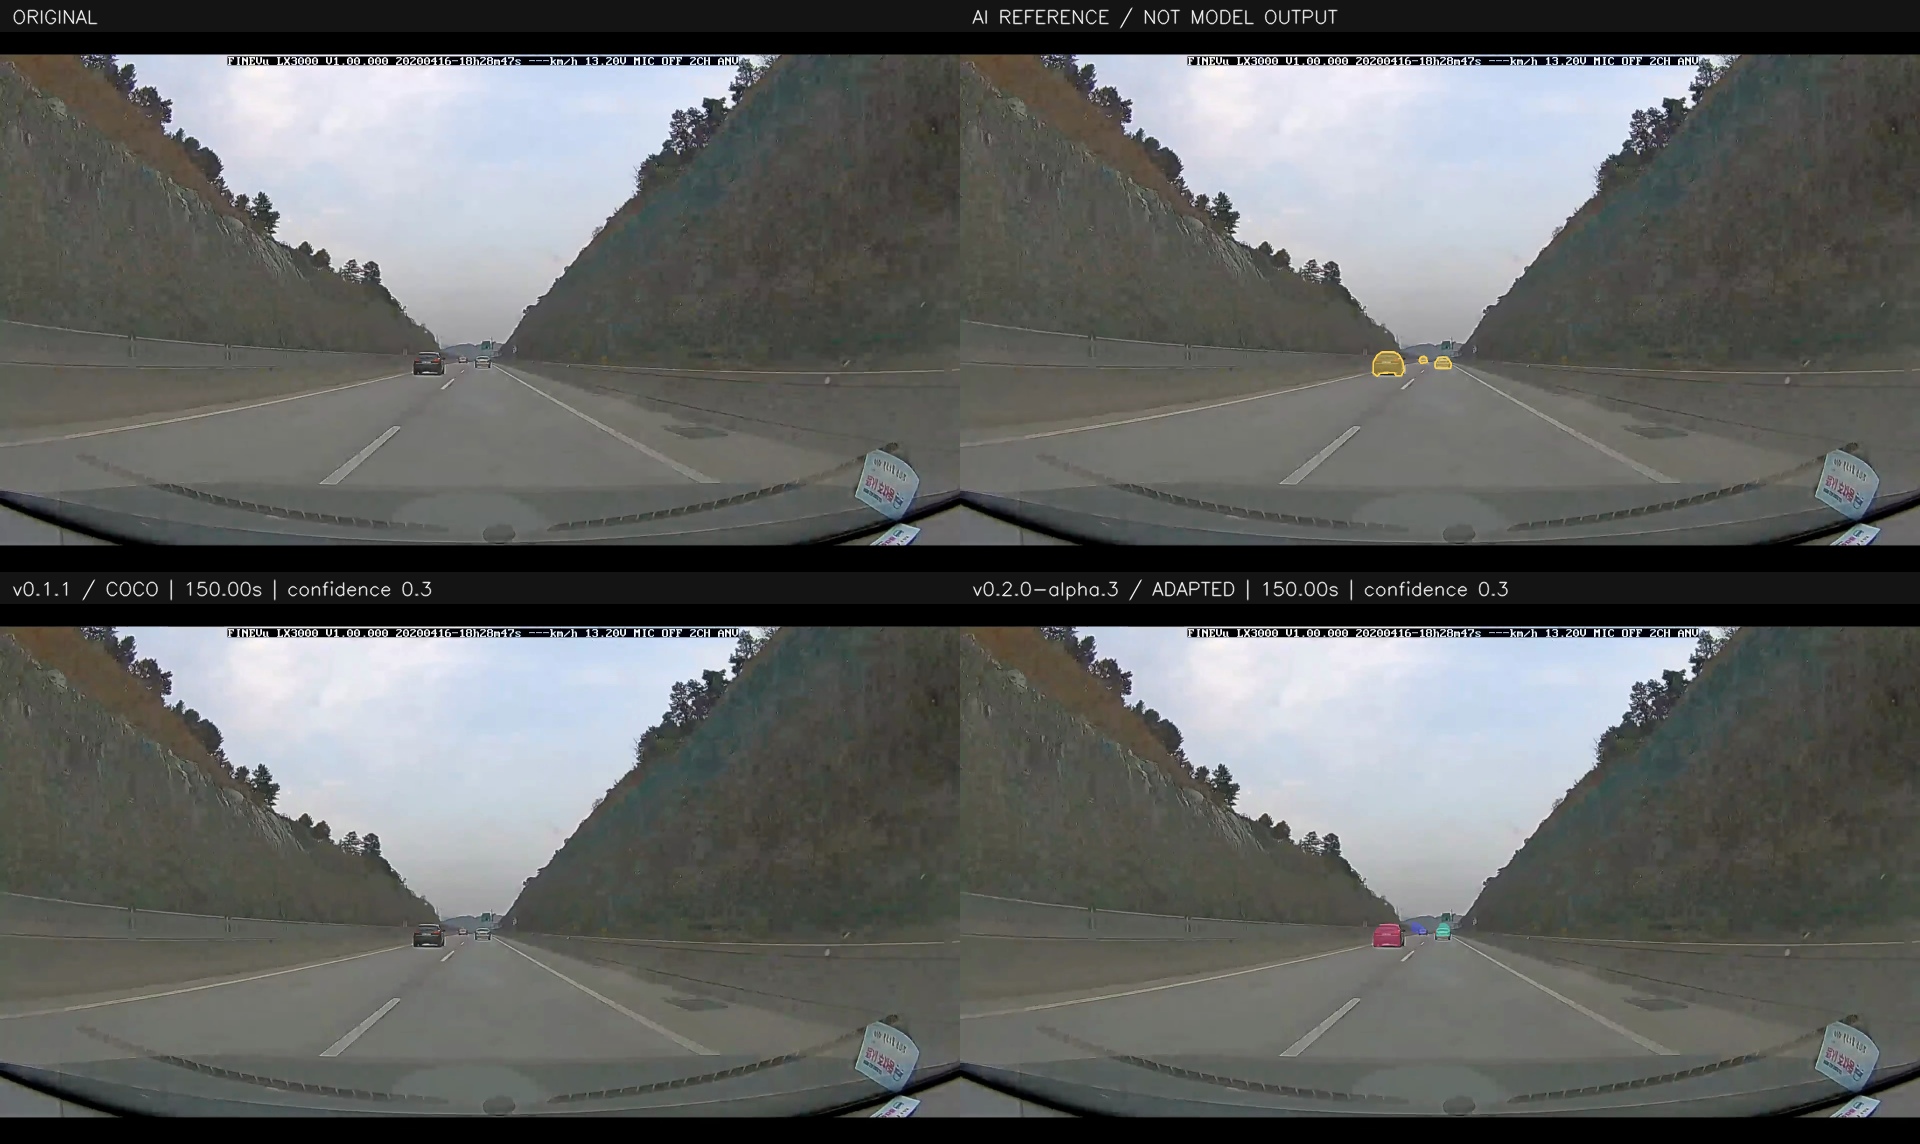 図8:150秒地点の比較。配置は図1と同じです。遠方の小さな車両も評価対象として意識する必要があります。2
flowchart TB
    A["残った失敗パターン"]
    B["車体の一部が塗られない<br/>切り出し領域の端で欠ける例"]
    C["1台の車が複数色になる<br/>複数の候補に分かれる例"]
    D["遠方の車を見逃す<br/>着色が途切れる例"]
    E["輪郭の取り方を改善する課題"]
    F["車両ごとの分離・対応付けの課題"]
    G["小さな車両への認識の課題"]
    A --> B --> E
    A --> C --> F
    A --> D --> G
図9:観察された失敗と、そこから整理した改善課題。個々の原因を実験で切り分けた結論ではありません。23
処理速度にも課題があります。同じMac/MPSでの20秒動画3本の処理では、改善版は書き出し込みで 9.95fps。元動画は24fpsなので、この測定では実時間処理に届いていません。入力解像度も旧モデルと異なるため、構造だけの速度比較ではありません。2
8. 公開した重みで、自分の動画を試す
推論モデルはHugging Face、結果動画や再開用の状態はGitHub Releaseで公開しています。推論だけなら、学習画像や参照注釈は不要です。5
:::details 環境構築とモデルの取得:macOS / Linux
Python 3.11以上と、libx264を含むFFmpegが必要です。ffmpegとffprobeの両方を実行できる状態にしてください。以下はREADMEに沿った実行例です。
# ソースと仮想環境を用意
git clone --branch v0.1.0 --depth 1 https://github.com/james-yusuke/jalo.git
cd jalo
python3 -m venv .venv
source .venv/bin/activate
python -m pip install .
python -m jalo doctor

# 公開モデルを取得
mkdir -p checkpoints
curl -fL \
   "https://huggingface.co/james-yusuke/jalo/resolve/main/jalo-local-vehicles-evaluated.pt?download=true" \
   -o checkpoints/jalo-local-vehicles-evaluated.pt
Windows PowerShellでは、仮想環境の有効化は .venv\Scripts\Activate.ps1 です。その他の環境構築はREADMEを参照してください。
:::
入力動画を demo.webm として置き、まず20秒だけ書き出します。
python -m jalo demo \
  --input demo.webm \
  --checkpoint checkpoints/jalo-local-vehicles-evaluated.pt \
  --render masks --duration 20 \
  --output outputs/demo_masks.mp4 \
  --device auto --no-preview
出力は outputs/demo_masks.mp4。--device auto はCUDA → MPS → CPUの順に選びますが、実機で確認済みなのはMac/MPSです。CUDA実機は未検証です。現行版は短い診断動画向けの研究版であり、運転中の安全判断に使うものではありません。5
9. 初めてのモデル公開は、次の実験の出発点
次の候補は、車両ごとの特徴をマスク予測へ渡す変更、周辺を含む領域での学習、データの多様化と独立した人手による参照確認です。いずれも未実装・未検証の案として、現状の結果とは分けています。3
flowchart TB
    A["JALO v0.1.0<br/>今回公開した基準モデル"]
    B["構造の改善案<br/>車両ごとの特徴をマスク予測へ"]
    C["学習方法の改善案<br/>周辺も含む領域で車体を学ぶ"]
    D["データの改善案<br/>多様な動画 + 人手で参照を確認"]
    E["新しい実験計画<br/>未使用の評価動画を用意"]
    F["再評価<br/>改善したかを確かめる"]
    A --> B
    A --> C
    A --> D
    B --> E
    C --> E
    D --> E
    E --> F
図10:次の実験の候補。実施済みの成果や、改善の保証を示す図ではありません。3
初めて事前学習モデルを作って公開できたことと、実用的な品質に到達したことは別です。 今回は前者まで。輪郭を塗れるようになった成果と、見逃し・塗り残しという課題を、両方残すことができました。
このJALOを出発点に、次は「動いた」から「より安定して認識できる」へ進めていきたいです。
比較画像の出典
図1・7・8はJALOリポジトリで公開している比較画像を改変せず参照しています。元映像はChoi Kwang-moによる原州市の運転動画(CC0 1.0)です。JALO側でフレーム抽出・注釈や予測の重畳・比較配置が行われた画像は、CC BY-SA 4.0として提供されています。ソースコードのMIT Licenseとは区別してください。6